Notre conception de la procédure « Know Your Customer » (KYC) a évolué rapidement au cours des dix dernières années. Nous pensons qu’une évolution d’une ampleur similaire aura lieu au cours des deux prochaines années, sous l’impulsion de notre compréhension grandissante du sujet, des changements réglementaires et de l’émergence de nouveaux processus rendus possibles par l’intelligence artificielle (IA).
Cela permettra aux entreprises de mettre en place un processus KYC « sans support papier », où la mise à jour, la révision et la gestion des changements importants s’effectueront automatiquement à partir de leurs interactions avec les clients, tout en s’appuyant sur un ensemble complet et robuste de procédures d’audit, de contrôles et de suivi.
À l’origine, dans le secteur de la banque privée, les informations KYC étaient, au mieux, conservées dans un ensemble disparate de documents ou dans un petit « carnet noir » rangé dans le tiroir d’un bureau. À mesure que la réglementation KYC a évolué, sous l’impulsion des exigences mondiales en matière d’adéquation et de lutte contre le blanchiment d’argent (AML), nous avons assisté à l’émergence de systèmes structurés destinés à collecter et à gérer ces données.
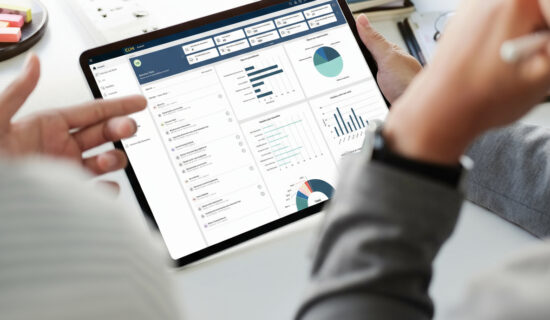
Chez Wealth Dynamix, nous avons intégré cette fonctionnalité à nos outils CLM (Client Lifecycle Management), ce qui facilite la collecte des informations KYC dès le premier rendez-vous et tout au long des révisions régulières.
Lorsqu’elle est correctement mise en œuvre, cette solution offre aux entreprises :
- Un « enregistrement de référence » unique des informations KYC du client
- Une véritable piste d’audit de toutes les modifications apportées aux informations KYC tout au long du cycle de vie d’un client, précisant ce qui a été modifié et par qui
- Des cycles clairs pour examiner et justifier les modifications au sein du processus KYC
Pour de nombreuses entreprises, cela reste un objectif lointain, les données KYC étant dispersées sur plusieurs systèmes, ce qui implique une ressaisie manuelle et des données de mauvaise qualité.
Mais ce n’est pas non plus la panacée pour tous les problèmes. Ce système repose essentiellement sur la rigueur du personnel chargé de la gestion des données KYC, qui doit traduire les mises à jour issues de ses interactions régulières avec les clients en mises à jour systématiques sur les plateformes utilisées pour gérer ces données.
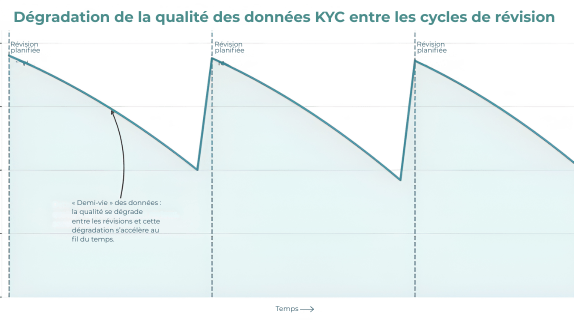
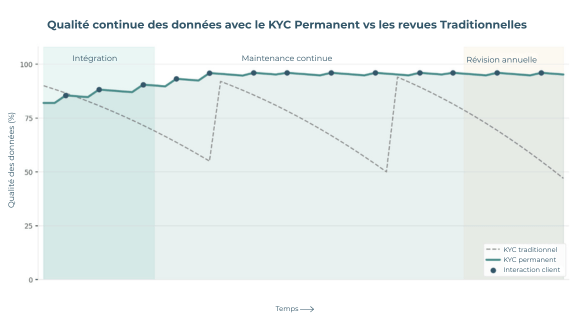
Alors que les employés des premiers quartiles du front-office d’une entreprise font souvent preuve de rigueur dans l’utilisation de ces systèmes, certains peuvent les utiliser de manière intermittente, voire pas du tout. Cela signifie que la qualité des données peut être inégale, atteignant dans certains cas un « pic » au moment de la révision par le client, puis se dégradant lentement jusqu’à la prochaine révision.
Cela s’explique par le fait que les données peuvent être considérées comme ayant une « demi-vie » : elles se dégradent rapidement au fil du temps depuis le dernier examen, le taux de dégradation augmentant à mesure que les données restent trop longtemps sans être vérifiées.
Relever ce défi
Wealth Dynamix a exploré plusieurs approches différentes pour accroître la fréquence des mises à jour tout au long du cycle de vie du client et pour l’ensemble des collaborateurs. L’un des axes prioritaires consiste à réduire les obstacles rencontrés par le personnel de première ligne lors de la saisie de ces mises à jour dans l’outil, grâce à des revues sur « une seule page », des formulaires KYC intelligents, des outils numériques collaboratifs et des règles automatisées.
Cependant, nous étions convaincus qu’il était possible d’aller plus loin et, au fil des années, nous avons cherché, tant en interne qu’avec nos partenaires, comment automatiser la mise à jour des données KYC. Cette démarche a toujours été limitée par des contraintes technologiques, mais avec l’essor des LLM (Large Language Models), nous sommes désormais en mesure de proposer une solution basée sur ce concept : un moteur KYC perpétuel qui met à jour les données KYC en temps réel, en fonction des mises à jour fournies par les clients.
Les principes fondamentaux
Les modifications relatives au KYC doivent être identifiées automatiquement à partir des interactions avec les clients, et non saisies manuellement par le personnel.
Le personnel ne devrait pas avoir à déterminer quelles règles s’appliquent aux différentes modifications de données ; le système devrait le faire automatiquement.
Les contrôles de conformité de deuxièmes et troisièmes lignes, visant à détecter les erreurs, à vérifier la cohérence et la plausibilité, devraient être automatiquement intégrés aux processus de modification et faire partie intégrante de votre première ligne de défense.
« Nous sommes désormais en mesure de proposer une solution basée sur ce concept : un moteur KYC permanent qui met à jour les données KYC en temps réel, en fonction des mises à jour fournies par les clients. »
Les contraintes fondamentales
Toute modification doit faire l’objet d’un audit complet, avec une trace claire indiquant qui l’a approuvée, pourquoi, quand et ce qui a été modifié. S’agissant de données réglementaires, les informations KYC doivent être conservées dans un format structuré afin de permettre des calculs et des rapports déterministes – c’est là qu’interviennent les approches traditionnelles, qui peuvent garantir une certitude et une cohérence à 100 % des réponses.
La sécurité est primordiale. Des mesures de protection robustes sont mises en place pour détecter et prévenir toute tentative de compromission des données, tandis que des contrôles d’accès granulaires garantissent que le personnel ne puisse consulter et mettre à jour que les informations pertinentes pour sa fonction.
Dans cette optique, notre système central est capable d’ingérer des données structurées et non structurées provenant de n’importe quelle source, d’identifier les parties potentiellement concernées par les modifications, puis de traiter celles-ci via un processus d’approbation clair.
Une fois qu’un changement est approuvé, il peut être acheminé via des processus déterministes de changement de circonstances, étayés par des pistes d’audit claires ainsi que par des mécanismes de vérification et d’approbation robustes. Ce faisant, les changements ayant une incidence sur les règles de conformité réglementaire sont détectés et acheminés vers l’équipe compétente.
Cette combinaison d’approches basées sur les modèles de langage de grande capacité (LLM) pour détecter les changements, associée à des approches déterministes plus traditionnelles pour calculer ensuite le risque, l’adéquation, la conformité FATCA et bien plus encore, offre le meilleur des deux mondes : une automatisation significative des tâches à faible valeur ajoutée, associée à une certitude à 100 % quant aux règles et aux calculs.
Après tout, vous ne pouvez pas présenter une conversation par chat à un organisme de réglementation pour justifier l’acceptation d’un client à haut risque !
Sources de données
- Données internes issues des interactions avec le personnel, qu’il s’agisse de notes d’appel, de comptes-rendus de réunions, de notes manuscrites, d’emails ou de messages sécurisés
- Documents fournis par les clients, allant des passeports à jour aux justificatifs de domicile, en passant par les justificatifs de l’origine des fonds
- Données publiques, provenant de sources professionnelles telles que LinkedIn ou d’articles de presse
- Données privées, provenant de sources propriétaires B2B et d’agrégateurs, ainsi que de bases de données spécialisées dans la recherche sur les clients fortunés et de fournisseurs tiers
Lorsqu’on examine les sources de données publiques, il est essentiel d’éviter de franchir la ligne qui sépare l’analyse pertinente de l’intrusion, en garantissant la transparence vis-à-vis des clients quant à la manière dont vous collectez et obtenez les données – un élément clé des règles mondiales en matière de protection des données – et en n’utilisant ces données que de manière respectueuse envers le client.
C’est là que le jugement humain reste irremplaçable : ce type de prise de décision nuancée que l’IA peut éclairer, mais qu’elle ne pourra jamais reproduire intégralement.
Quel est donc l’impact pour vous ?
Une fois mis en œuvre, le KYC perpétuel a trois effets principaux :
- Une réduction immédiate de l’effort nécessaire à la gestion des procédures KYC
- Une amélioration secondaire de la qualité des données
- Un effet continu où la réduction de l’effort et l’amélioration de la qualité des données entraînent un cercle vertueux d’amélioration des données
Cette amélioration de la qualité des données encourage une utilisation accrue de celles-ci, ce qui, à son tour, entraîne de nouvelles améliorations de leur qualité.
Prospection
Les dossiers KYC sont automatiquement mis à jour grâce à la collecte d’informations et aux premiers contacts, complétés par des sources de données publiques. Cette amélioration de la qualité permet d’identifier de nouveaux angles d’approche, tels que les liens communs au sein d’une entreprise, et d’augmenter globalement les taux de conversion.
Onboarding
Les dossiers d’onboarding sont automatiquement alimentés à partir des documents collectés, ainsi que des données enrichies recueillies lors de la phase de prospection. Les agents effectuent automatiquement des contrôles de cohérence et de plausibilité, ce qui permet de détecter les problèmes potentiels plus tôt dans le processus et de réduire considérablement les délais et les efforts liés à l’onboarding.
Conclusion
L’essor de l’IA permet d’adopter une nouvelle approche de la gestion du KYC et des processus associés de prospection, d’intégration et de contrôle. Lorsqu’elle est mise en œuvre correctement, cette approche engendre un cercle vertueux, dans lequel l’amélioration de la qualité stimule l’utilisation, et l’utilisation entraîne à son tour de nouvelles améliorations de la qualité.
Toutefois, dans un secteur réglementé, cela n’est possible que si cette approche s’appuie sur une couche déterministe, capable de calculer les risques, de gérer l’audit et la sécurité, et de structurer les données avec une certitude absolue.